Progetto in corso · Intelligenza artificiale
ExplAIn
Costruiamo strumenti per capire come decide un’intelligenza artificiale.
- si fidano ancora del modello, dopo averne visto la spiegazione
- 3 su 27
- programmi analizzati, metà malware e metà puliti
- 420
- livelli di rischio nell’AI Act europeo
- 4
- il diritto a una spiegazione
- Art. 86
Per chi viene da informatica, matematica, filosofia, diritto
Perché spiegare
Un modello di intelligenza artificiale dà una risposta ma quasi mai dice perché. Se la risposta è giusta per il motivo sbagliato, nessuno se ne accorge finché il motivo sbagliato non smette di funzionare.
I metodi di spiegazione non cambiano il modello: gli mettono accanto uno strumento di diagnosi, che mostra quali parti dell’ingresso hanno deciso la risposta. È così che si trovano gli errori che non si vedono.
Il lupo e la neve
Nel 2016 Ribeiro, Singh e Guestrin hanno addestrato di proposito un modello sbagliato: in tutte le foto di esempio i lupi erano sulla neve e gli husky no. Il modello ha imparato la neve: dice lupo se c’è neve, husky se non c’è, qualunque animale ci sia.
Il loro metodo, LIME, accende e spegne gruppi di pixel e guarda come cambia la risposta, poi costruisce un modello semplice che imita quello vero vicino a quell’immagine. La spiegazione evidenzia la neve.
Hanno mostrato le risposte a 27 studenti con almeno un corso di machine learning. Prima della spiegazione 10 si fidavano del modello; dopo, solo 3.
I numeri del grafico
| Persone | prima della spiegazione | dopo |
|---|---|---|
| Si fidano del modello | 10 | 3 |
| Indicano la neve come indizio | 12 | 25 |
Integrated Gradients
Un altro metodo parte da un ingresso neutro, per esempio un’immagine nera, e arriva all’ingresso vero a piccoli passi. A ogni passo misura quanto la risposta è sensibile a ogni pezzo dell’ingresso, e somma i contributi.
IG_i(x) = (x_i − x′_i) · ∫ da 0 a 1  ∂F(x′ + α·(x − x′)) / ∂x_i  dα

x    l’ingresso vero          x′   l’ingresso neutro
F    il modello               α    il passo, da 0 a 1

in pratica: da 20 a 300 passi, e la somma dei contributi deve dare F(x) − F(x′)- 01
Completezza
I contributi sommati danno esattamente la differenza fra la risposta vera e quella neutra.
- 02
Sensibilità
Se cambiare un pezzo cambia la risposta, quel pezzo riceve un contributo.
- 03
Indipendenza dal codice
Due reti che calcolano la stessa funzione hanno le stesse spiegazioni.
- 04
Simmetria
Pezzi scambiabili e uguali ricevono lo stesso contributo.
Il malware e i byte che non contano
Alcuni rilevatori di malware leggono direttamente i byte dei programmi Windows, e funzionano molto bene. Ma su cosa decidono? Lo studio di Perasso e colleghi, presentato a Ital-IA 2025, lo misura con Integrated Gradients su due reti, MalConv e BBDNN, con 210 malware di sette famiglie e 210 programmi puliti di Windows 11.
In un programma ci sono zone che non dovrebbero contare: l’intestazione DOS, che resta solo per compatibilità; gli spazi vuoti fra le sezioni; i byte aggiunti in coda. E c’è il codice vero, la sezione .text. Entrambe le reti danno la parte principale della rilevanza al codice, ma una quota consistente finisce nelle zone che non contano, soprattutto negli spazi vuoti dei programmi puliti.
I numeri del grafico
| Rete e programmi | Rilevanza media |
|---|---|
| MalConv (programmi puliti) | 0,26 |
| MalConv (malware) | 0,09 |
| BBDNN (programmi puliti) | 0,41 |
| BBDNN (malware) | 0,11 |
La traduzione dal turco
In turco il pronome «o» vale sia per lui sia per lei. Uno studio pubblicato su Science nel 2017 ha mostrato che traducendo «O bir doktor. O bir hemşire.» Google Translate scriveva «He is a doctor. She is a nurse.»: lui medico, lei infermiera. Il genere non c’era nella frase, l’ha aggiunto il modello, imparandolo dai testi.
Dal dicembre 2018, per frasi brevi dal turco, Google mostra entrambe le traduzioni. Il pregiudizio era nei dati; per vederlo è servito guardare dentro le risposte.
Le regole europee
L’AI Act, il regolamento europeo 2024/1689, è in vigore dal 1° agosto 2024 e divide i sistemi di intelligenza artificiale in quattro livelli di rischio. Per quelli ad alto rischio chiede trasparenza, sorveglianza umana, accuratezza e robustezza; e chi subisce una decisione presa con il loro aiuto ha diritto a una spiegazione, all’articolo 86.
- Rischio inaccettabile vietato: punteggio sociale, manipolazione, riconoscimento delle emozioni a scuola e al lavoro
- Alto rischio istruzione, lavoro, servizi essenziali, infrastrutture critiche, dispositivi medici
- Rischio di trasparenza chatbot e contenuti generati vanno dichiarati
- Rischio minimo nessun obbligo: filtri antispam, videogiochi
I numeri del grafico
| Livello | |
|---|---|
| Rischio inaccettabile | vietato: punteggio sociale, manipolazione, riconoscimento delle emozioni a scuola e al lavoro |
| Alto rischio | istruzione, lavoro, servizi essenziali, infrastrutture critiche, dispositivi medici |
| Rischio di trasparenza | chatbot e contenuti generati vanno dichiarati |
| Rischio minimo | nessun obbligo: filtri antispam, videogiochi |
- 21 aprile 2021La Commissione europea propone il regolamento.
- 1° agosto 2024Il regolamento 2024/1689 entra in vigore.
- 2 febbraio 2025Si applicano i divieti.
- 2 agosto 2025Si applicano le regole sui modelli per finalità generali.
- 27 luglio 2026Entra in vigore il regolamento 2026/1744, che sposta le scadenze per l’alto rischio.
- 2 dicembre 2027Obblighi per i sistemi ad alto rischio delle aree dell’allegato III, come istruzione e lavoro.
- 2 agosto 2028Obblighi per l’intelligenza artificiale dentro prodotti regolati, come i dispositivi medici.
A che punto siamo
- Giugno 2025A Ital-IA 2025, a Trieste, lo studio sulle correlazioni spurie nel rilevamento del malware: è uno dei tre casi del progetto.
- Aprile 2026Abbiamo presentato il progetto a Palazzo della Borsa, con tre casi: immagini, sicurezza informatica e traduzioni.
- Prossimo passoUna cassetta degli attrezzi che chiunque possa riusare, pronta per le regole europee sull’intelligenza artificiale.
Foto
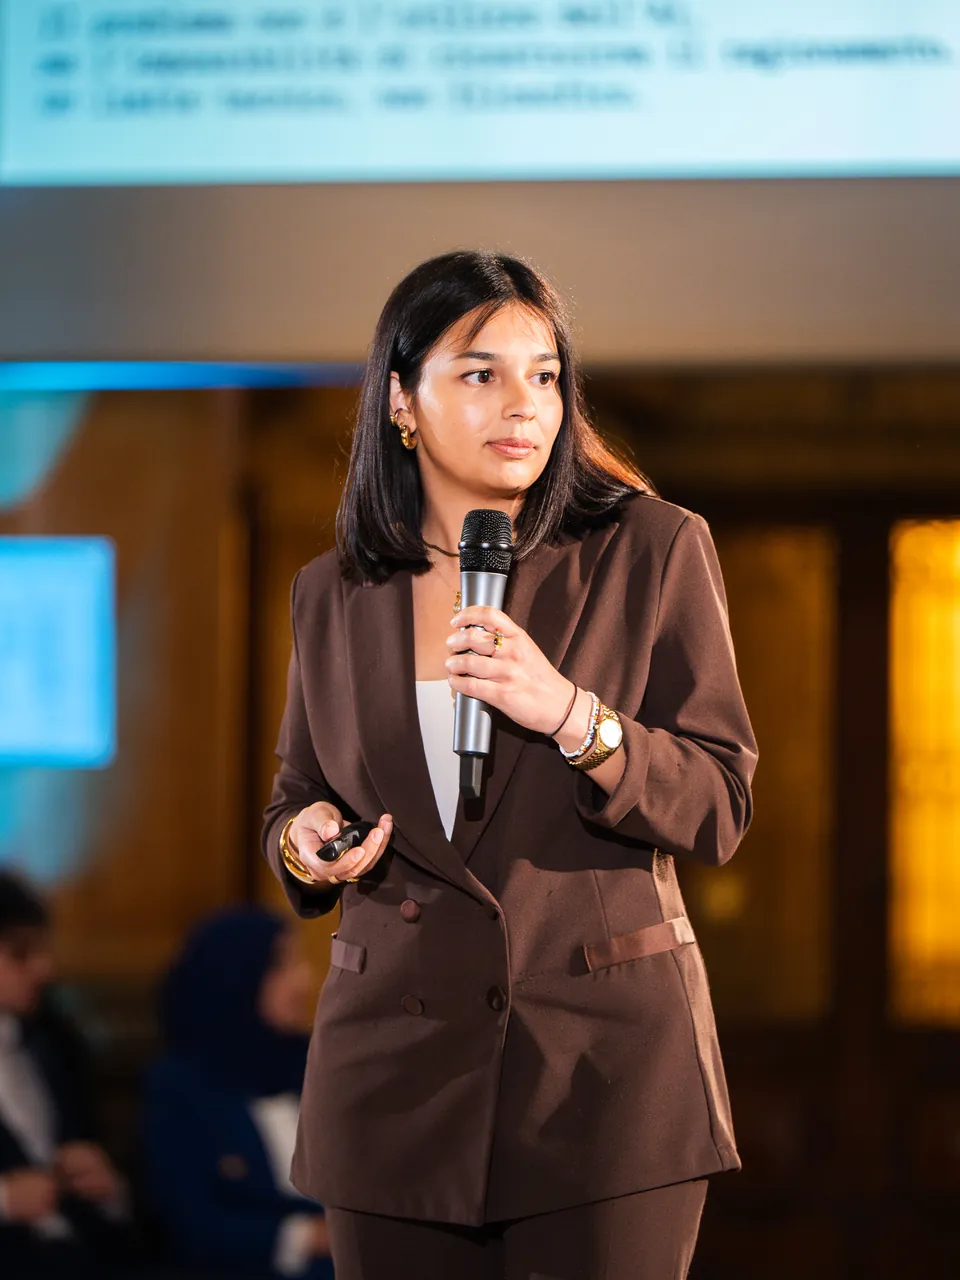
Persone del progetto

Con chi lo facciamo


Fonti
- Ribeiro, Singh e Guestrin, «Why Should I Trust You?», KDD 2016.
- Sundararajan, Taly e Yan, Axiomatic Attribution for Deep Networks, ICML 2017.
- Perasso, Lozza, Ponte, Demetrio, Oneto e Roli, Empirical Quantification of Spurious Correlations in Malware Detection, Ital-IA 2025, CEUR Workshop Proceedings 4121.
- Caliskan, Bryson e Narayanan, Science, 2017; Google, Reducing gender bias in Google Translate, 2018.
- Regolamento (UE) 2024/1689 e regolamento (UE) 2026/1744.
- Presentazione del Deep-Tech Showcase, Palazzo della Borsa, 21 aprile 2026.
Vuoi lavorarci?
Non serve esperienza e non serve un curriculum. Scrivici: ti invitiamo al prossimo incontro, dove conosci la squadra.